Written by Mario Larrúa Vega.
Abres un catálogo para escoger un modelo y acabas con seis pestañas de precios, tres anuncios pendientes de leer y una question que sigue sin respuesta: ¿cuál va a funcionar mejor con tus datos y tu presupuesto?
La dificultad no nace de la falta de opciones. Nace de que estamos comparando cosas distintas como si fueran equivalentes: una suscripción para trabajar, una API por consumo, un agente que ejecuta herramientas y una capacidad reservada en la nube. Todos prometen productividad. Cada uno cuenta el consumo a su manera.
Desde la perspectiva de un analista de IA, la question que merece presupuesto es bastante concreta: ¿cuánto cuesta conseguir un resultado válido, en el tiempo que necesito y dentro de las condiciones que puedo aceptar? Esa question permite entender tanto la oportunidad de Microsoft como los espacios en los que la competencia puede superarlo.
El precio del token cuenta solo una parte de la historia
Referencia de conversión · 22 OCT 2026
1 EUR = 1,1205 USD · 1 USD ≈ 0,89246 EUR
Los importes en USD son las referencias originales del artículo. Los EUR se calculan dividiendo los USD entre 1,1205, con el tipo de referencia del Banco Central Europeo del 22 de octubre de 2026. Son equivalencias informativas, sin IVA, comisiones ni ajustes de cambio del proveedor; no son tarifas oficiales en euros. Los importes futuros conservan este mismo cambio para facilitar la comparación.
Un token es una unidad de representación que utiliza el modelo. No equivale siempre a una palabra y la misma frase puede producir recuentos diferentes según el tokenizador. Por eso, traducir automáticamente «un millón de tokens» a un número fijo de documentos en español es una mala base para presupuestar.
La tabla siguiente recoge referencias públicas recientes. Son precios de texto con equivalencia orientativa en euros, sin impuestos, acuerdos privados ni herramientas adicionales. En Azure se indica Global Standard y contexto corto; en Anthropic y Google, sus API directas. Comparar estas tarifas sirve para modelar escenarios, no para declarar que los servicios ofrecen lo mismo.
| Modelo y canal | Entrada | Lectura de caché | Output |
|---|---|---|---|
GPT-6 LunaMicrosoft Azure · Foundry · Global StandardCondiciones y fuenteTexto, contexto corto. No incluye otros despliegues geográficos ni herramientas. Consultar tarifa oficial ↗ | 0,10 USD≈ 0,08925 EUR | 0,01 USD≈ 0,00892 EUR | 0,50 USD≈ 0,44623 EUR |
GPT-6.1 SolMicrosoft Azure · Foundry · Global StandardCondiciones y fuenteTexto, contexto corto. El contexto largo tiene otras tarifas. No incluye recargos por zona, caché ni herramientas. Consultar tarifa oficial ↗ | 2,00 USD≈ 1,78 EUR | 0,10 USD≈ 0,08925 EUR | 10,00 USD≈ 8,92 EUR |
GPT-6 AstraMicrosoft Azure · Foundry · Global StandardCondiciones y fuenteTexto, contexto corto. El contexto largo tiene otras tarifas. No incluye recargos por zona, caché ni herramientas. Consultar tarifa oficial ↗ | 10,00 USD≈ 8,92 EUR | 1,00 USD≈ 0,89246 EUR | 50,00 USD≈ 44,62 EUR |
Claude Haiku 5.5Anthropic · API directa · StandardCondiciones y fuenteTramo base hasta 100.000 tokens de entrada por petición. Por encima cambia la tarifa de entrada y salida para la petición completa. Consultar tarifa oficial ↗ | 0,10 USD≈ 0,08925 EUR | 0,01 USD≈ 0,00892 EUR | 0,50 USD≈ 0,44623 EUR |
Claude Sonnet 5.5Anthropic · API directa · StandardCondiciones y fuenteAPI directa; no es una cotización de Claude en Azure, AWS o Google Cloud. Excluye Fast, Batch, residencia y herramientas. Consultar tarifa oficial ↗ | 2,00 USD≈ 1,78 EUR | 0,10 USD≈ 0,08925 EUR | 10,00 USD≈ 8,92 EUR |
Claude Opus 5.5Anthropic · API directa · StandardCondiciones y fuenteAPI directa en modo Standard. Excluye Fast, Batch, residencia y herramientas. Consultar tarifa oficial ↗ | 4,00 USD≈ 3,57 EUR | 0,20 USD≈ 0,17849 EUR | 20,00 USD≈ 17,85 EUR |
Gemini 4 ArgonGoogle · Gemini API · StandardCondiciones y fuentePrecio introductorio hasta el 30/11/2026. La salida incluye pensamiento. No incluye búsquedas ni otras herramientas. La tarifa posterior anunciada comienza el 01/12/2026; puedes simularla en la calculadora. Consultar tarifa oficial ↗ | 2,00 USD≈ 1,78 EUR | 0,10 USD≈ 0,08925 EUR | 10,00 USD≈ 8,92 EUR |
Gemini 3.8 FlashGoogle · Gemini API · StandardCondiciones y fuentePrecio introductorio hasta el 31/12/2026. La salida incluye pensamiento. No incluye búsquedas ni almacenamiento de caché. La tarifa posterior anunciada comienza el 01/01/2027; puedes simularla en la calculadora. Consultar tarifa oficial ↗ | 0,75 USD≈ 0,66934 EUR | 0,075 USD≈ 0,06693 EUR | 3,75 USD≈ 3,35 EUR |
Fuentes consultadas el 22 de octubre de 2026. USD originales; EUR orientativos al cambio 1 EUR = 1,1205 USD. La tabla muestra los precios introductorios de Google y el tramo base de Haiku. Abre «Condiciones y fuente» para revisar el alcance de cada tarifa.
Sources: resumen de Foundry publicado el 15 de octubre, tabla oficial de precios y ponderaciones de Azure, anuncio de Sonnet 5.5 and tarifas de Gemini API. Las tarifas de Azure se contrastan con las referencias oficiales enlazadas. Confirma el importe de tu despliegue antes de contratar.
Hay dos lecturas. La primera es la amplitud de precios: en estas referencias, Astra cuesta cien veces más por token que Luna. Eso no demuestra que Luna resuelva una tarea compleja ni que Astra sea una mala inversión. Demuestra que enviar todo al mismo modelo puede salir caro.
La segunda es menos evidente: Sol, Sonnet y Argon coinciden hoy en 2,00 USD (≈ 1,78 EUR) de entrada y 10,00 USD (≈ 8,92 EUR) de salida. Sin embargo, no tienen por qué consumir los mismos tokens para resolver el mismo trabajo. Y, en el caso de Argon, esa coincidencia tiene una fecha de vencimiento publicada.
Una tarifa es una propiedad del servicio. El coste por resultado es una propiedad de tu sistema.
La respuesta corta también puede tener una factura larga
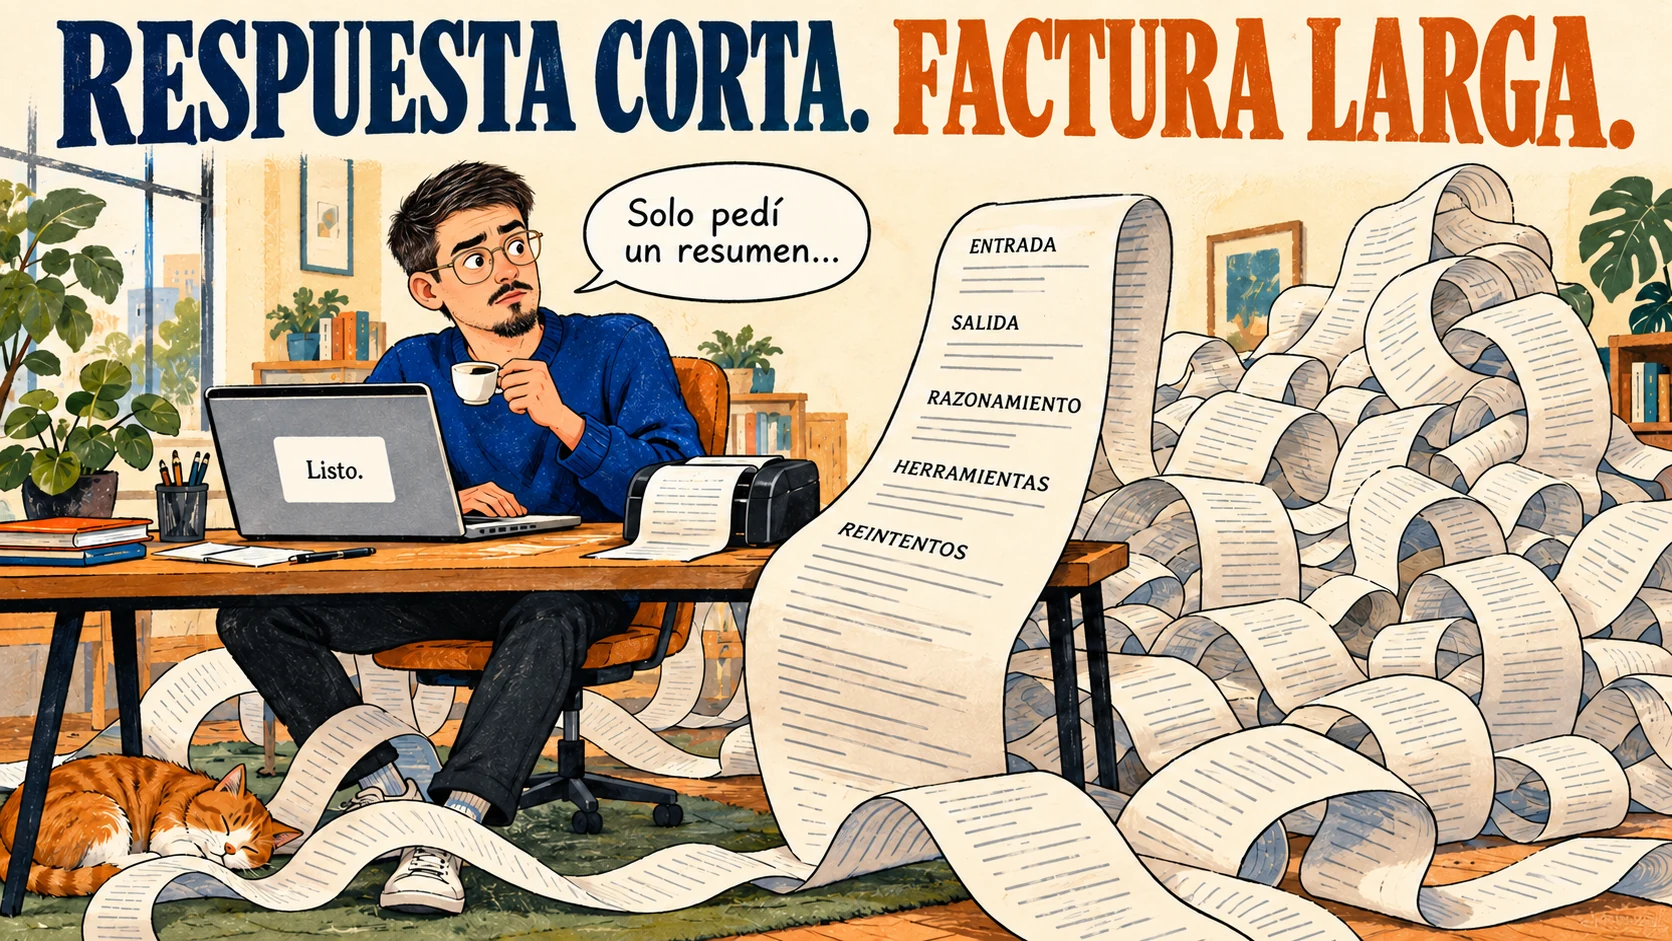
FIG. 02 «Solo pedí un resumen…» Mario ante la cuenta: el tamaño de la respuesta visible no basta para calcular el consumo. La factura interminable es una exageración humorística; los conceptos facturables dependen del proveedor y de la configuración.
En una aplicación real, la entrada incluye bastante más que la question: instrucciones, historial, documentos recuperados, definiciones de herramientas y resultados de llamadas anteriores. Cada paso adicional del agente puede volver a enviar parte de ese material.
A eso hay que sumar el razonamiento. La documentación oficial de Gemini incluye los tokens de pensamiento en el precio de salida; la de GPT-6.1 Sol identifica el soporte de tokens de razonamiento. El texto visible, por sí solo, no permite reconstruir el consumo. También cambian las reglas del contexto largo: Azure publica tarifas específicas para esos tramos y para las escrituras de caché. Tarifas Gemini, ficha oficial de GPT-6.1 Sol and ponderaciones Azure.
Coste de inferencia =
(entrada sin caché × tarifa de entrada
+ lectura de caché × tarifa de lectura
+ escritura de caché × tarifa de escritura
+ salida facturable × tarifa de salida) / 1.000.000
Las categorías deben ser excluyentes según el proveedor para evitar contar dos veces los mismos tokens. Después se añaden herramientas, búsquedas, almacenamiento, infraestructura, evaluaciones y revisión humana, cuando correspondan.
La caché merece atención, pero tampoco conviene convertirla en una promesa de ahorro automático. Hay que cumplir las condiciones del servicio y medir los aciertos reales. Un prefijo estable puede ayudar; una conversación que cambia de modelo o reordena el contexto puede producir otro comportamiento.
Un ejemplo: 100.000 consultas al mes
Supongamos un asistente interno con 2.000 tokens de entrada sin caché y 500 tokens de salida facturable por consulta. Una sola llamada por consulta, sin herramientas ni reintentos y con todas las peticiones en contexto corto. El volumen mensual es de 200 millones de tokens de entrada y 50 millones de salida.
| Configuration | Entrada mensual | Salida mensual | Total mensual |
|---|---|---|---|
| Todo con GPT-6 Luna | 20,00 USD≈ 17,85 EUR | 25,00 USD≈ 22,31 EUR | 45,00 USD≈ 40,16 EUR |
| Todo con GPT-6.1 Sol | 400,00 USD≈ 356,98 EUR | 500,00 USD≈ 446,23 EUR | 900,00 USD≈ 803,21 EUR |
| Todo con GPT-6 Astra | 2000,00 USD≈ 1784,92 EUR | 2500,00 USD≈ 2231,15 EUR | 4500,00 USD≈ 4016,06 EUR |
| Mezcla hipotética: 80 % Luna, 18 % Sol, 2 % Astra | 128,00 USD≈ 114,23 EUR | 160,00 USD≈ 142,79 EUR | 288,00 USD≈ 257,03 EUR |
Escenario mensual / 100.000 consultas
Una carga. Cuatro facturas posibles.
USD originales y equivalentes orientativos en EUR.
- Luna
- 45,00 USD≈ 40,16 EUR
- Mezcla de modelos
- 288,00 USD≈ 257,03 EUR
- Sol
- 900,00 USD≈ 803,21 EUR
- Astra
- 4.500,00 USD≈ 4.016,06 EUR
−68 %La mezcla hipotética frente a Sol para toda la carga. La calidad equivalente debe verificarse.
La mezcla reduce un 68 % el gasto frente a usar Sol para todo. Es una operación aritmética, no una promesa de ahorro de Model Router. Solo tendría sentido si esa distribución mantuviera la calidad exigida. Si primero responde Luna y luego hay que repetir la consulta con Sol, deben contarse ambas ejecuciones.
Otra forma de mirar el problema: en una prueba ficticia de 1.000 tareas, una configuración que gaste 40,00 USD (≈ 35,70 EUR) y consiga 600 resultados aceptados cuesta 0,0667 USD (≈ 0,05953 EUR) por resultado aceptado. Otra que gaste 60,00 USD (≈ 53,55 EUR) y consiga 950 baja a 0,0632 USD (≈ 0,05640 EUR). La tarifa más alta puede ser la opción más eficiente. Si añadimos el tiempo de corrección humana, la diferencia puede crecer.
La calculadora incluye los ocho modelos de la tabla, agrupados por canal, y una opción de tarifa personalizada para otras ofertas. Permite simular los cambios de precio anunciados por Google y aplica el tramo de Haiku correspondiente a la entrada indicada. Sus importes son una referencia fechada, no un catálogo actualizado en tiempo real.
Simulación / USD y EUR
¿Cuánto costaría tu carga de trabajo?
8 modelos de Azure, Anthropic y Google, más una tarifa personalizada. Compara el mismo volumen de texto; la calidad y los tokens necesarios para resolver una tarea pueden variar entre modelos.
Tarifa aplicada · por millón de tokens
- Entrada
- 2,00 USD≈ 1,78 EUR
- Output
- 10,00 USD≈ 8,92 EUR
Texto en Foundry Global Standard, contexto corto.
Aplicada la tarifa de referencia del artículo.
Ver tarifa oficial ↗Estimación mensual de inferencia
- Entrada mensual
- 400,00 USD · ≈ 356,98 EUR
- Salida mensual
- 500,00 USD · ≈ 446,23 EUR
Una llamada por consulta. Sin caché, herramientas, búsquedas, reintentos, Batch ni recargos geográficos. Incluye el razonamiento dentro de la salida facturable que indiques. No comprueba si la petición cabe en el contexto del modelo.
Tarifas contrastadas el 22 de octubre de 2026; no se actualizan automáticamente. EUR orientativos al cambio BCE de esa fecha: 1 EUR = 1,1205 USD. Sin IVA ni ajustes del proveedor. El cálculo se realiza en tu navegador.
Dónde tiene Microsoft una ventaja defendible
Mi lectura es que Microsoft gana fuerza cuando la elección del modelo deja de ser una decisión aislada y se convierte en parte de la operación de la empresa. Para una organización que ya trabaja con Microsoft 365 y Azure, el valor potencial está en reducir el trabajo que rodea a la inferencia: conectar información, administrar accesos, integrar aplicaciones y entender el gasto.
1. Un catálogo multivendor que también puede enrutar
El registro de cambios de octubre de Model Router documenta un conjunto de 35 modelos, con incorporaciones de OpenAI, Anthropic, xAI y modelos servidos por Fireworks. La documentación permite configurar modos de coste, calidad o equilibrio y restringir el conjunto elegible. Novedades de Model Router and funcionamiento y límites.
Eso tiene valor práctico: puedo ensayar otra familia de modelos sin tener que diseñar desde cero toda la capa de selección. Pero hay una condición que suele perderse en las presentaciones: estar en el catálogo de Foundry no significa estar disponible en el conjunto del router. Tampoco significa que todas las herramientas, regiones y API sean compatibles.
Por ejemplo, el registro de octubre menciona Claude Sonnet 5 entre las incorporaciones. No basta con ver Sonnet 5.5 en Foundry para dar por hecho que el router ya lo selecciona. Además, Claude requiere despliegue previo para utilizarse mediante el router. El contexto efectivo también depende de los modelos elegibles. Requisitos de Model Router.
2. La información de trabajo pesa tanto como el modelo
La propuesta reciente de Copilot refuerza la conexión entre aplicaciones, datos empresariales y trabajo delegado. El anuncio del 25 de septiembre presentó Home, Code y Autopilot, con distintos calendarios de acceso, además de capacidades de FinOps para IA. Anuncio oficial del nuevo Copilot.
La oportunidad comercial se entiende con una escena cotidiana: preparar una propuesta que necesita documentos de trabajo, contexto comercial y una hoja de cálculo. Si la plataforma facilita reunir ese material y devolver archivos utilizables, parte del valor aparece antes y después de la llamada al modelo. Para una empresa integrada en Microsoft, ese ahorro de integración puede pesar más que una pequeña diferencia de tarifa.
Es una hipótesis económica que cada organización debe validar. También tiene un reverso: cuanto más se apoye un proceso en funciones específicas de una plataforma, más esfuerzo puede requerir trasladarlo. Diversificar modelos dentro de Azure reduce una dependencia concreta; no elimina la dependencia de la plataforma.
3. Más capacidad de observar lo que ocurre
Las novedades de septiembre incorporan metadatos de enrutamiento por petición y afinidad de sesión, ambos en vista previa. Permiten investigar decisiones y cambios de modelo; la afinidad intenta mantener el mismo modelo elegible entre turnos, sin garantizarlo. Registro oficial de cambios.
Para el analista, esto ayuda a formular questions mejores: ¿qué modelo resolvió el caso?, ¿hubo una ruta de respaldo?, ¿el cambio de coste vino del modelo, de más contexto o de más pasos? El panel que solo muestra tokens totales se queda corto para responderlas.
La región y el alojamiento también forman parte del precio
Para alguien que trabaja desde España, conviene detenerse aquí. Un recurso creado en una región europea y un servicio con procesamiento dentro de la UE no son conceptos intercambiables. Hay que revisar el tipo de despliegue y las condiciones de cada modelo.
La actualización de precios de Microsoft con efecto desde el 1 de septiembre mantiene Global sin cambios y fija EU Data Zone un 20 % por encima de Global dentro del ámbito de esa política. Los cambios de Standard afectan a modelos lanzados desde esa fecha; determinados cambios de PTU tienen otro alcance. No hay que confundir el incremento respecto a la tarifa anterior con el recargo total respecto a Global. Política de precios de despliegue and aclaración de octubre.
Aplicar hipotéticamente un 20 % sobre los 900,00 USD (≈ 803,21 EUR) del ejemplo llevaría el cálculo a 1.080,00 USD (≈ 963,86 EUR). Es una ilustración del efecto geográfico; la cotización real debe comprobarse para el modelo, la zona y el contrato concretos.
Claude en Foundry exige mirar una capa más. Microsoft distingue alojamiento en Azure y alojamiento en infraestructura de Anthropic. En ambas opciones, Anthropic figura como vendedor y encargado independiente del tratamiento. La comparación consultada enumera Global Standard y Data Zone Standard de EE. UU. para Azure-hosted; no enumera una Data Zone de la UE. En Anthropic-hosted, los datos pueden procesarse fuera de Azure y de la región seleccionada. Comparación oficial de alojamiento de Claude.
El mismo documento describe facturación mediante Claude Consumption Units y elegibilidad para MACC. Esa integración puede facilitar la compra a determinados clientes de Azure, pero no convierte las condiciones de Claude en las de Azure OpenAI. Es un buen ejemplo de por qué una factura unificada no equivale a unas condiciones técnicas uniformes.
La competencia también está resolviendo problemas importantes
Priorizar tecnología Microsoft exige ser preciso sobre cuándo aporta valor. No obliga a adjudicarle todas las ventajas. Tampoco sería riguroso afirmar quién está ganando cuota de mercado a partir de anuncios: lo siguiente compara capacidades y oportunidades competitivas, no participación de mercado medida.
| Option | Por qué incluirla en la evaluación | Cuándo puede tener ventaja frente a Microsoft |
|---|---|---|
| Microsoft Foundry + Copilot | Selección multivendor, herramientas empresariales y enrutamiento administrado. | Cuando el proceso ya vive en Azure y Microsoft 365 y el coste de integración es relevante. |
| Anthropic / Claude | Sonnet 5.5 centra su propuesta reciente en eficiencia por tarea, programación y creación de documentos. | Cuando Claude logra mejores resultados en el conjunto de pruebas propio y la API directa cubre el flujo necesario. |
| Google / Gemini | Argon aporta contexto compartido amplio, generación larga y comprensión de vídeo; Flash ofrece otro tramo de precio. | Cuando esas modalidades o un entorno ya asentado en Google reducen trabajo de implementación. |
| AWS / Bedrock | También ofrece selección de modelos y enrutamiento de prompts. | Cuando datos, permisos y operación ya están en AWS y migrarlos no añade valor suficiente. |
| API directa de OpenAI | Permite contrastar el mismo modelo con las opciones y condiciones de su servicio directo. | Cuando una capacidad concreta del servicio directo resulta decisiva; debe verificarse la paridad con Azure. |
| Modelos locales o con pesos abiertos | Permiten explorar otros controles de despliegue y otra estructura de costes. | Cuando hardware, latencia y calidad encajan. Hay que contabilizar operación y licencias, no solo inferencia. |
Anthropic aporta un ejemplo especialmente útil: en el lanzamiento de Sonnet 5.5 afirma que mantiene las tarifas de Sonnet 5, pero reduce el coste por tarea hasta un 30 % en sus pruebas porque necesita menos tokens. Es una afirmación del fabricante, no un ahorro verificado aquí. Su propia publicación muestra que el nivel de esfuerzo altera la relación entre calidad y coste. Presentación de Sonnet 5.5.
Google documenta en Argon una ventana compartida de 1.048.576 tokens para entrada, pensamiento y salida, con generación larga y niveles de pensamiento ajustables. Esa capacidad puede abrir casos de uso, pero también obliga a controlar cuánto se genera. Documentación actual de Gemini 4 Argon.
AWS confirma que el enrutamiento administrado tampoco es exclusivo de Microsoft. Su página de precios describe Intelligent Prompt Routing dentro de una misma familia y publica un cargo de 1,00 USD (≈ 0,89246 EUR) por cada 1.000 peticiones. Ese cargo del router debe añadirse a la inferencia al comparar. Precios de Amazon Bedrock.
La conclusión competitiva es más interesante que una clasificación de ganadores: todos intentan vender una forma de gestionar la complejidad. Microsoft tiene una posición atractiva allí donde puede conectar esa gestión con el trabajo que la empresa ya realiza en sus productos. En una organización asentada en otra nube, esa ventaja debe demostrarse de nuevo.
Cuatro compras distintas que conviene separar
Una licencia de Copilot, el consumo de un agente, una API y una reserva de capacidad responden a necesidades diferentes. La comparación económica debe hacerse al nivel del proceso completo.
| Modalidad | Question útil | Error habitual |
|---|---|---|
| Suscripción de trabajo | ¿Qué funciones, límites y trabajo útil obtiene cada usuario? | Tratar la licencia como una API ilimitada o asumir que todo uso de agentes está incluido. |
| API por consumo | ¿Cuántos tokens y llamadas necesita cada resultado válido? | Presupuestar solo la primera respuesta. |
| Agentes y herramientas | ¿Cuánto cuesta completar el flujo y controlar sus acciones? | Ignorar búsquedas, ejecuciones, almacenamiento y reintentos. |
| Capacidad provisionada | ¿Hay demanda sostenida y requisitos que justifiquen reservarla? | Comparar una reserva infrautilizada con una tarifa marginal por token. |
Microsoft documenta Global Batch para procesamiento asíncrono con un coste un 50 % menor que Global Standard y un objetivo de entrega de 24 horas, sin SLA de respuesta en tiempo real. Para una carga nocturna compatible puede ser relevante; para una conversación inmediata cambia la experiencia. La disponibilidad depende del modelo. Tipos de despliegue de Foundry.
Lo reciente que sí merece seguimiento
La parte útil de una hoja de ruta es saber qué decisión podría cambiar. Este es el radar que seguiría, distinguiendo disponibilidad, vista previa y trabajo aún en desarrollo.
| Novedad | Fecha y estado | Qué puede cambiar |
|---|---|---|
| Routines y Tool Search | El resumen publicado el 15/10 las confirma en disponibilidad general. | Programar agentes y cargar definiciones de herramientas bajo demanda. Medir contexto y ejecuciones antes de atribuir ahorro. |
| Insights en Foundry | Vista previa pública, recogida en el resumen de septiembre. | Investigar hallazgos apoyados en trazas. Revisar evidencia y coste de evaluación. |
| Model Router | Octubre: conjunto de 35 modelos. Afinidad de sesión y metadatos: vista previa. | Más alternativas y mejor diagnóstico del comportamiento entre turnos. |
| MAI-Base-2 | 15/10: preentrenamiento completado; en postentrenamiento. | Base de la próxima generación de modelos Microsoft. El anuncio no establece una fecha comercial universal. |
| Azure Maia | 12/10: Maia 200 en producción. Maia 300 anunciado para 2027. | Más control de Microsoft sobre la infraestructura de inferencia. No implica una rebaja automática de tarifas. |
| Home, Code y Autopilot | Anuncio del 25/09: despliegues Frontier para Home/Code y ampliación de vista previa privada para Autopilot. | Trabajo delegado y creación de soluciones desde Copilot. Confirmar acceso efectivo en el tenant. |
| MAI-Transcribe-2-Streaming y MAI-Voice-2.1 | Anunciados el 01/10, junto con Voice-2.1-Flash. | Evaluar componentes especializados para voz. Revisar canal y disponibilidad antes de diseñar su uso. |
Sources: Foundry, resumen de septiembre; Model Router, cambios de octubre; MAI-Base-2; Maia; Copilot; modelos de voz del 1 de octubre.
La combinación MAI y Maia merece atención estratégica: Microsoft está desarrollando tanto modelos como infraestructura propia. Mi interpretación es que eso amplía su margen para optimizar productos y costes internos. Cuánto llegará al cliente, con qué condiciones y cuándo, todavía requiere anuncios concretos. Eficiencia de entrenamiento, eficiencia de inferencia y precio comercial son métricas distintas.
Foundry Local también merece una prueba acotada si el caso admite inferencia local. La documentación consultada mantiene la CLI en vista previa y describe un SDK que integra el runtime en la aplicación. La prueba útil consiste en medir memoria, latencia y calidad en el equipo objetivo. Ejecutar localmente desplaza costes hacia el dispositivo y su operación. Guía actual de Foundry Local.
Cómo escogería hoy una arquitectura para una empresa Microsoft
Empezaría por el trabajo concreto y por una línea base reproducible. Un buen punto de partida para un piloto puede ser un conjunto de 100 a 300 casos anonimizados que incluya español, documentos propios, ambigüedades y errores reales. Esa cifra es una propuesta de trabajo, no una garantía de representatividad.
- Definir qué cuenta como resultado válido. En extracción: campos correctos y trazables. En soporte: resolución sin inventar políticas. En código: cambio que supera las comprobaciones requeridas.
- Descartar opciones que incumplan requisitos. Alojamiento, tratamiento de datos, herramientas, contexto y acceso disponible. No tiene sentido afinar el precio de un despliegue que no se puede utilizar.
- Medir una línea base con un solo modelo. Guardar versión, configuración, contexto, consumo facturado y latencia. Después comparar otras configuraciones sobre los mismos casos.
- Probar el nivel de razonamiento. Subirlo cuando resuelva errores relevantes. Mantenerlo alto para todo puede pagar trabajo que el caso no necesita.
- Introducir enrutamiento solo con evidencia. Comparar el sistema enrutado con la línea base y revisar cada grupo de tareas. Un ahorro medio puede ocultar errores en los casos importantes.
- Evaluar caché y Batch por separado. Usar aciertos observados de caché y confirmar que la carga acepta procesamiento asíncrono.
- Repetir la evaluación ante cambios relevantes. Nueva versión, modificación de prompt, cambio de herramienta o de tarifa. Mantener una vía de reversión comprobada.
Marco de decisión / Elaboración propia
Del catálogo a una decisión defendible
- 01
Filtrar
Datos, alojamiento, capacidades y acceso disponible.
- 02
Medir
Calidad, coste por resultado y latencia p95 en casos propios.
- 03
Operar
Elegir la opción que cumple los umbrales y controlar los cambios.
Observar Reevaluar Ajustar
En un asistente de soporte integrado con Microsoft, probaría una familia económica para clasificar y extraer datos, una intermedia para respuestas con documentación y una opción más capaz para los casos difíciles. Son roles a validar, no una asignación automática por nombre comercial. Una consulta sobre facturación puede ser breve y aun así necesitar datos precisos y controles estrictos.
El cuadro de mando debería mostrar coste por tarea aceptada, tasa de aceptación sin corrección, latencia p95 —el tiempo por debajo del que termina el 95 % de las peticiones—, errores críticos, llamadas a herramientas y minutos de revisión. También registraría contexto, aciertos de caché y cambios de modelo. Esos datos permiten discutir una inversión; una captura de un benchmark rara vez basta.
El modelo de este mes no debería convertirse en una dependencia de años
La abundancia de modelos puede resultar agotadora, pero también permite comprar capacidad de forma más ajustada al trabajo. La condición es conservar un método que sobreviva al siguiente lanzamiento.
Microsoft tiene una propuesta especialmente atractiva para las empresas que ya trabajan en su ecosistema: reunir opciones de modelos, contexto empresarial y herramientas de operación. Esa es su ventaja potencial más sólida. El precio más bajo o la mayor calidad habrá que demostrarlos en cada carga.
Como analista, me interesa menos acertar el nombre del modelo del mes que poder explicar por qué lo elegimos, cuánto cuesta cada resultado y qué evidencia nos haría cambiarlo.
Artículos y documentación para comprobarlo
Fuentes primarias consultadas el 22 de octubre de 2026. Se distingue la fecha del anuncio de la de disponibilidad. Las comparaciones económicas y el método de evaluación son análisis propios; no se han ejecutado benchmarks ni contratado servicios para este artículo.
- Microsoft · 15 octubre · Qué hay de nuevo en Foundry: septiembre de 2026. Modelos, herramientas, estados de disponibilidad y aclaraciones sobre precios.
- Microsoft Learn · consulta actual · Precios y ponderaciones para dimensionar PTU. Referencia oficial de entrada, caché y salida para Astra y Sol.
- Microsoft Learn · cambios de octubre · Novedades de Model Router. Modelos admitidos y funciones en vista previa.
- Microsoft Learn · consulta actual · Cómo funciona Model Router. Modos de enrutamiento, requisitos y limitaciones.
- Microsoft · política efectiva en septiembre · Actualización de precios de despliegue. Diferencias entre Global, Data Zone y Regional.
- Microsoft Learn · consulta actual · Alojamiento de Claude en Foundry. Tratamiento de datos, ubicación, compra y facturación.
- Anthropic · 28 septiembre · Presentación de Claude Sonnet 5.5. Tarifas, eficiencia declarada y relación entre esfuerzo y coste.
- Anthropic · consulta actual · Tarifas oficiales de Claude. Precios de Haiku, Sonnet y Opus 5.5 y tramo de Haiku para peticiones de más de 100.000 tokens.
- Google · consulta actual · Tarifas de Gemini API. Precios promocionales y fechas de los cambios anunciados.
- Google · consulta actual · Guía de Gemini 4 Argon. Contexto compartido, generación larga y niveles de pensamiento.
- AWS · consulta actual · Precios de Amazon Bedrock. Enrutamiento de prompts y cargo por petición.
- OpenAI Docs · consulta actual · Ficha de GPT-6.1 Sol. Capacidades y condiciones del servicio directo.
- Microsoft · 25 septiembre · Copilot: Home, Code y Autopilot. Trabajo delegado, herramientas y fases de acceso anunciadas.
- Microsoft AI · 15 octubre · Preentrenamiento de MAI-Base-2. Modelo base en postentrenamiento y dirección de investigación.
- Microsoft · 12 octubre · Maia 200 y el plan para Maia 300. Producción actual y hoja de ruta para 2027.
- Microsoft AI · 1 octubre · Nuevos modelos de transcripción y voz. MAI-Transcribe-2-Streaming y MAI-Voice-2.1.
- Microsoft Learn · consulta actual · Tipos de despliegue de Foundry. Batch, Data Zone y modalidades de capacidad.
- Microsoft Learn · consulta actual · Foundry Local: guía actual. Estado de vista previa y distinción entre CLI y SDK.
- Banco Central Europeo · 22 octubre · Tipo de referencia EUR / USD. Base de todas las equivalencias en euros de esta edición: 1 EUR = 1,1205 USD.
Información contrastada el 22 de octubre de 2026. Caricaturas editoriales personalizadas a partir de mis fotografías y generadas con IA; las escenas son metáforas humorísticas. Los gráficos y cálculos son de elaboración propia. Los ejemplos son simulaciones. Revisar tarifas, cambio y disponibilidad si se pospone la publicación.